"글은 백지에서 시작하지 않는다. 메모에서 시작한다."
메모법 강연과 책에서 자주 듣는 말입니다. 날마다 읽은 것을 적어 두고, 적어 둔 것을 서로 이어 두면, 글을 쓸 때가 되어 빈 화면 앞에서 막막해하는 일이 없어진다는 약속입니다. 그 약속에는 늘 한 사람의 이름이 따라붙습니다. 독일의 사회학자 니클라스 루만(Niklas Luhmann, 1927~1998)입니다. 그는 평생 손으로 쓴 메모 9만 장을 나무 상자에 넣어 두고 썼고, 그 상자 덕분에 보통 학자 몇 사람 몫의 글을 냈다고 전해집니다.
그런데 이 이야기는 한 번 따져 볼 필요가 있습니다. 9만 장은 정확한 숫자일까요. 그 메모들은 어떻게 연결되어 있었을까요. 그리고 요즘 인터넷에서 돌아다니는 임시 메모, 문헌 메모, 영구 메모라는 세 종류 구분은 정말 루만이 만든 것일까요. 마지막으로, 글의 첫 문장부터 인공지능(AI)이 대신 써 주는 시대에 메모를 쌓는 일이 아직 뜻이 있을까요.
다행히 루만의 메모상자는 지금 빌레펠트 대학의 아카이브에 통째로 보관되어 있고, 그 내용을 세어 본 기록이 공개되어 있습니다. 거기서부터 출발하겠습니다. 미리 말씀드리면 — 메모상자는 글을 대신 써 주지 않았습니다. 대신 쓰기 시작하는 자리를 백지에서 이미 적어 둔 문장으로 옮겨 주었습니다. 그 차이가 이 글의 전부입니다.
상자 안에는 정말 9만 장이 있었나
루만은 1968년부터 1993년까지 빌레펠트 대학의 사회학 교수였습니다. 그가 세상을 떠난 뒤 남긴 자료는 2011년에 빌레펠트 대학이 재단의 지원을 받아 사들였습니다. 대학의 루만 아카이브는 그 자료의 중심을 이렇게 적어 두었습니다. 1951년부터 1996년 사이에 쓴, 약 9만 장의 메모로 이루어진 메모상자(Zettelkasten)입니다[1]. 메모는 A6, 그러니까 엽서 크기의 종이에 손으로 썼습니다[2].
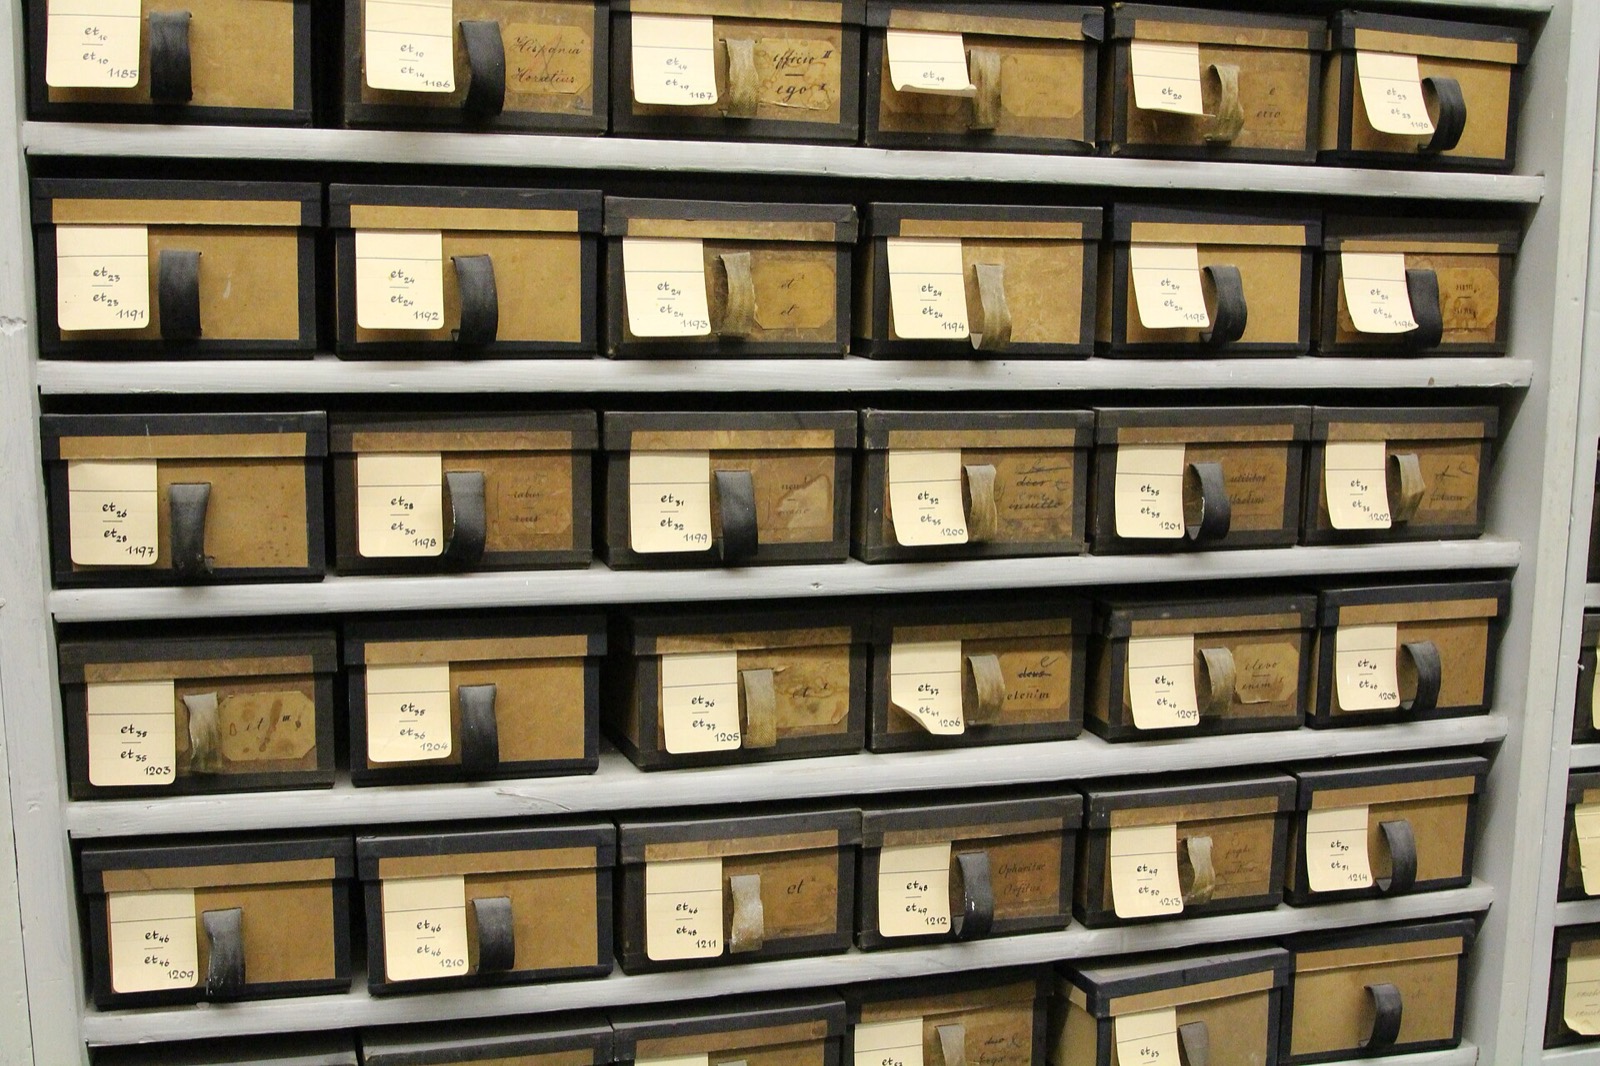

상자는 사실 하나가 아니라 둘입니다. 아카이브를 맡은 요하네스 슈미트의 집계로, 첫 번째 상자는 1950년대 초부터 1962년까지 쓴 것으로 약 2만 3천 장에서 2만 4천 장이 108개 구획으로 나뉘어 있습니다. 두 번째 상자는 1963년부터 생애 끝까지 쓴 것으로 약 6만 6천 장에서 6만 7천 장이 11개 구획에 들어 있습니다. 두 상자를 합치면 9만 장이 됩니다[3][2]. 자료마다 천 단위가 조금씩 다른 것은 디지털화 작업이 아직 진행 중이기 때문입니다. 이 작업은 2015년에 시작해 2030년까지 이어질 예정입니다[4].
그 메모로 얼마나 썼을까요. 아카이브 소개문은 600편에 가까운 출판물, 그 가운데 단행본이 40권 넘는다고 적습니다[1]. 2018년에 아카이브 연구진이 발표에 쓴 자료는 생전에 단행본 40권과 논문 500편으로 셉니다[3]. 셈하는 방식에 따라 수치가 달라지지만, 어느 쪽으로 세어도 한 사람의 학자가 30년 동안 낸 양으로는 드문 분량입니다. 루만 자신은 이 상자 없이는 그런 생각에 이르지 못했을 것이라고 1987년 인터뷰에서 말했습니다. 자기 머리가 필요한 것은 맞지만, 머리 혼자서 책임질 수 있는 일은 아니었다는 것입니다[3].
메모는 어떻게 서로 이어져 있었나
9만 장이라는 숫자보다 중요한 것은 그 메모들이 어떤 순서로 꽂혀 있었느냐입니다. 보통 메모를 모으면 주제별로 칸을 나눕니다. 경제, 법, 종교 하는 식으로요. 루만은 그렇게 하지 않았습니다. 그가 1981년에 쓴 짧은 글 「메모상자와의 소통」에서 직접 설명한 원칙은 이렇습니다. 메모마다 번호를 하나 붙이고, 한번 붙인 번호와 자리는 절대 바꾸지 않습니다. 자리가 고정되어 있으니 주제별로 분류할 필요가 없습니다[5].
그러면 새 메모는 어디에 들어갈까요. 맨 뒤에 덧붙이는 것이 아니라, 관련 있는 기존 메모 바로 뒤에 끼워 넣습니다. 번호는 가지를 치듯 늘어납니다. 1번 메모 뒤에 이어지는 생각이 나면 1/1, 거기서 다시 곁가지가 나면 1/1a, 그 곁가지의 곁가지는 1/1a1이 되는 식입니다. 슈미트가 든 실제 사례 하나는 21/3d5b11w19z6a입니다. 가장 긴 번호는 열세 자리에 이릅니다[3][2]. 번호가 길다는 것은 그 자리에서 생각이 여러 번 갈라져 나갔다는 뜻입니다. 번호 자체가 생각의 이력입니다.
번호가 바뀌지 않는다는 규칙에서 두 번째 장치가 나옵니다. 참조입니다. 모든 메모에 고정된 번호가 있으니, 어떤 메모에든 "21/3d를 보라"는 식으로 다른 메모의 번호를 적어 둘 수 있습니다. 루만은 원하는 만큼 참조를 달 수 있다고 썼습니다[5]. 아카이브의 집계로 첫 번째 상자에는 약 2만 개, 두 번째 상자에는 약 3만 개의 참조가 있습니다[3]. 첫 상자는 메모 2만 3천여 장에 참조 2만 개이니 메모 한 장에 참조가 거의 하나씩 있는 셈이고, 둘째 상자는 메모 6만 7천여 장에 참조 3만 개이니 두 장에 하나꼴입니다[2]. 아카이브 연구진은 이 참조망이 있어야 비로소 메모상자가 "놀라움을 만들어 내는 장치"가 된다고 표현했습니다[3].
세 번째 장치는 색인입니다. 주제별 분류를 포기했으니 어디서 찾기 시작할지 알려 주는 입구가 필요합니다. 루만은 핵심어 색인을 따로 두었습니다[5]. 두 번째 상자의 색인에는 약 3,200개의 항목이 있는데, 메모가 6만 7천 장이니 메모 스무 장에 색인 항목 하나꼴입니다. 더 눈여겨볼 것은 항목마다 적힌 메모 번호가 한 개에서 네 개뿐이라는 점입니다[2]. 색인은 입구만 열어 주면 되고, 나머지 관련 메모는 참조를 따라가면 나오기 때문입니다. 색인이 입구이고, 참조가 길이고, 고정 번호가 그 길을 가능하게 하는 바닥입니다.
그래서 글쓰기가 쉬워졌을까
여기서 처음 질문으로 돌아가겠습니다. 메모가 쌓이면 글이 저절로 나올까요. 루만 자신의 답은 조심스럽습니다. 1981년 글에서 그는 자기 경험으로는 메모 내용을 베껴 적는 방식으로 논문이 나오지는 않는다고 썼습니다[5]. 메모상자의 쓸모는 다른 데 있었습니다. 그는 메모상자를 소통 상대로 불렀습니다. 소통이 되려면 상대가 나를 놀라게 할 수 있어야 하는데, 메모상자는 예전의 내가 적어 둔 것을 지금의 내가 예상 못 한 조합으로 되돌려 준다는 것입니다. 그의 표현으로는 "결코 계획된 적 없는 조합의 가능성"을 내놓습니다[5].
그 상자가 실제로 글이 된 과정을 들여다볼 수 있는 자리가 하나 있습니다. 방금 인용한 1981년 글 자체입니다. 글쓰기 교사 죙케 아렌스(Sönke Ahrens)는 자기 책의 부록에서 루만의 상자 가운데 9/8번으로 시작하는 구역을 소개합니다. 이 구역의 메모 17장이 바로 그 여덟 쪽짜리 글의 밑감이었습니다. 9/8 뒤로 9/8a부터 9/8j까지 열 장이 이어지고, 9/8,1부터 9/8,3까지 세 장이 따로 갈라지며, 9/8a와 9/8b에서 다시 두 장씩 곁가지가 납니다[6]. 앞 그림에서 본 번호 규칙이 그대로 작동하고 있습니다.
그 메모들 가운데 9/8b에는 이런 말이 적혀 있습니다. 메모상자는 정화조 같은 것이어서 다 정리된 메모만 넣어서는 안 되며, 검토와 결정을 미루는 것도 속도의 문제라는 것입니다[6]. 완성된 생각만 넣는 상자가 아니라 덜 익은 생각을 넣어 두고 나중에 다시 만나는 상자였다는 뜻입니다. 아렌스는 메모 몇 장은 출판된 글과 거의 같은 문장이지만, 다른 메모들은 바깥 사람이 읽으면 두 오랜 친구의 대화를 엿듣는 것처럼 뜻을 다 알기 어렵다고 덧붙입니다[6].
그러니 답은 이렇습니다. 메모상자는 글을 쉽게 만들지 않았습니다. 글의 시작점을 옮겼습니다. 백지 앞에서 무엇을 쓸지 고르는 일 대신, 이미 적힌 17장을 다시 읽고 그 사이의 빈 곳을 메우는 일로요. 그리고 그 효과는 바로 오지 않았습니다. 루만은 같은 글에서 메모상자가 쓸 만한 덩어리가 되기까지 몇 년이 걸린다고 적었습니다[5]. 그가 아카이브 인터뷰에서 자기 머리만으로는 그런 생각에 이르지 못했을 것이라고 말한 것은, 상자가 똑똑해서가 아니라 수십 년 치의 자기 자신이 거기 들어 있었기 때문입니다.
세 종류 메모는 누구의 것인가
이제 흔히 루만의 것으로 소개되는 구분을 보겠습니다. 임시 메모(fleeting note), 문헌 메모(literature note), 영구 메모(permanent note)의 셋입니다. 떠오른 생각을 놓치지 않으려 급히 적는 것이 임시 메모, 읽은 것을 제 말로 짧게 옮겨 출처와 함께 적는 것이 문헌 메모, 그 둘을 바탕으로 자기 생각을 완전한 문장으로 써서 상자에 넣는 것이 영구 메모라는 설명입니다.
이 세 이름은 루만의 글에 나오지 않습니다. 2017년에 아렌스가 낸 책 『How to Take Smart Notes』의 틀입니다[7]. 우리말로는 2021년에 『제텔카스텐: 글 쓰는 인간을 위한 두 번째 뇌』라는 제목으로 나왔습니다[8]. 아렌스는 영구 메모를 "그 자체로 필요한 정보를 영구히 이해할 수 있는 형태로 담은" 메모, "인쇄될 것처럼 써서" 상자에 넣는 메모로 정의하고, 임시 메모는 다른 일을 하는 중에 생각을 빨리 붙잡아 두는 용도라고 썼습니다[9]. 루만의 실제 작업 방식에 가까운 것은 두 상자였습니다. 책을 읽고 나면 종이 한 면에 서지 정보를, 다른 면에 내용 메모를 적어 서지 상자에 넣고, 그다음에야 그 메모가 자기 생각에 어떤 뜻이 있는지 따져 본 메모를 본 상자에 넣으며 기존 메모와 연결했다는 것이 아렌스의 설명입니다[7].
이 구분이 틀렸다는 뜻은 아닙니다. 배우기 쉬운 좋은 틀입니다. 다만 출처를 바로 알아 두면 얻는 것이 있습니다. 세 종류 이름보다 루만에게 중요했던 것은 메모가 어디에 꽂히고 무엇과 이어지느냐였다는 점입니다. 아렌스 자신도 2판 부록에서 그렇게 씁니다. 소프트웨어를 쓰는 사람에게 루만의 번호 체계는 필요 없지만, 그 번호가 시키는 일 하나는 남는다고요. 새 메모는 되도록 기존 메모에 대한 답으로 쓰라는 것, 낱낱의 조각을 모으지 말고 이어지는 대화를 계속하라는 것입니다[6].
AI가 첫 문장을 써 주는 시대에 메모가 남을까
이제 가장 현실적인 질문입니다. 생각을 적어 두는 수고를 들이지 않아도 AI가 첫 문단을 써 주는데, 메모를 쌓는 일이 아직 뜻이 있을까요. 이 질문에 바로 답하는 실험이 2025년에 하나 나왔습니다. 매사추세츠 공과대학(MIT) 미디어랩의 나탈리야 코스미나 연구진이 6월에 올린 「Your Brain on ChatGPT」입니다[10].
설계는 이렇습니다. 보스턴 지역의 18세에서 39세 사이 54명을 세 집단으로 나눴습니다. 한 집단은 챗GPT(ChatGPT)만 써서, 한 집단은 검색 엔진만 써서, 한 집단은 아무 도구 없이 머리로만 에세이를 썼습니다. 세 집단이니 한 집단은 열여덟 명꼴입니다. 같은 조건으로 세 번 쓰는 동안 뇌파(EEG)로 뇌 32개 영역의 활동을 쟀고, 쓰고 나서 몇 분 뒤에 자기 글에서 한 문장을 인용해 보라고 했습니다. 넉 달에 걸친 실험이었고, 네 번째 회차에는 54명 가운데 18명, 그러니까 3분의 1이 돌아와 조건을 바꿔 썼습니다. 챗GPT를 쓰던 사람은 도구 없이, 머리로만 쓰던 사람은 챗GPT를 써서요[10][11].
결과는 한 방향을 가리켰습니다. 뇌 영역 사이의 연결은 머리로만 쓴 집단이 가장 강했고, 검색 엔진 집단이 중간, 챗GPT 집단이 가장 약했습니다. 연구진의 표현으로는 바깥 도움의 양에 따라 연결이 체계적으로 줄었습니다. 챗GPT 집단은 몇 분 전에 쓴 자기 글을 인용하는 데서도 뒤처졌고, 그 글이 자기 것이라는 느낌도 가장 낮았습니다. 네 번째 회차에서 챗GPT를 쓰다가 도구를 뺀 사람들은 연결이 약한 채로 남았고, 반대로 머리로만 쓰다가 챗GPT를 받은 사람들은 기억 회상이 더 좋았고 뇌 활동도 다시 올라왔습니다[10].
이 실험은 한계를 분명히 안고 있습니다. 연구진 스스로 가장 먼저 밝힌 것들입니다. 첫째, 동료 심사를 거치지 않은 공개본(preprint)이어서 결론은 "주의해서, 예비적인 것으로" 읽어야 합니다. 둘째, 참가자가 54명으로 적고 한 지역에서 모집했습니다. 셋째, 시험한 것은 챗GPT 하나이고, 과제는 교육 상황의 에세이 쓰기 하나입니다. 넷째, 뇌파는 뇌 어느 자리에서 일어난 일인지 정밀하게 짚지 못합니다[11]. 연구진은 언론에 "멍청해진다", "뇌가 썩는다" 같은 말을 쓰지 말아 달라고 따로 부탁했고, 논문에도 그런 말은 없습니다[12]. 연구 책임자는 동료 심사를 기다리지 않고 먼저 공개한 이유로, 몇 달 뒤 어느 정책 담당자가 유치원에서부터 생성형 AI를 쓰게 하자고 결정할까 걱정됐다고 말했습니다[13].
그러니 이 실험에서 가져올 수 있는 것은 "AI를 쓰면 안 된다"가 아닙니다. 가져올 것은 세 집단의 순서입니다. 검색 엔진 집단이 중간에 있었다는 점이 눈에 띕니다. 찾아 주는 도구와 써 주는 도구는 머리에 남기는 흔적이 달랐습니다. 그리고 네 번째 회차에서, 먼저 자기 머리로 써 본 사람이 나중에 AI를 받았을 때는 기억도 뇌 활동도 좋았습니다. 순서가 결과를 바꿨습니다.
여기서부터는 해석입니다. 루만의 메모상자로 돌아가 보면 이 결과가 낯설지 않습니다. 루만이 상자에서 얻은 것은 문장이 아니라 놀라움이었고, 상자가 놀라움을 줄 수 있었던 것은 그 안의 모든 문장을 그가 직접 썼기 때문입니다. 1981년 글의 첫머리에서 그는 글을 쓰지 않고는 적어도 정교하고 학문적인 방식으로는 생각할 수 없다고 적었습니다[5]. MIT 실험에서 자기 글을 인용하지 못한 사람들은 그 글을 쓰지 않은 사람들입니다. 메모가 글쓰기를 쉽게 만드는 것은 메모가 쌓여서가 아니라, 쌓이는 동안 그 문장들이 한 번씩 내 손을 거쳤기 때문입니다. AI가 그 손 대신 쓰면 상자는 남아도 놀라움은 사라집니다. 반대로 AI가 루만의 색인과 참조가 하던 일, 곧 관련 있는 옛 메모를 찾아 주고 뜻밖의 연결을 제안하는 일을 맡는다면, 그것은 루만이 메모상자에게 바랐던 역할과 같습니다.
오늘 시작할 수 있는 가장 작은 메모 습관
9만 장을 목표로 삼을 필요는 없습니다. 루만의 상자에서 글이 되어 나온 구역은 17장이었습니다. 위에서 확인한 것들로 가장 작은 습관을 짜 보면 이렇습니다.
먼저, 한 장에 생각 하나를 자기 문장으로 씁니다. 아렌스가 말한 영구 메모의 기준, 곧 나중에 맥락 없이 읽어도 뜻이 통하는 완전한 문장이면 됩니다[9]. 책에서 옮겨 적은 구절은 출처와 함께 따로 둡니다. 루만의 서지 상자가 하던 일입니다. 종이든 앱이든 상관없지만, 자리를 한 곳으로 정하고 옮기지 않습니다. 루만의 번호가 바뀌지 않았던 이유가 바로 나중에 그 자리를 가리킬 수 있어야 해서였습니다.
다음으로, 새 메모를 쓸 때는 먼저 기존 메모 하나를 찾아 그 뒤에 씁니다. 아렌스의 부록에 있는 그 한 문장, 새 메모는 되도록 기존 메모에 대한 답으로 쓰라는 것입니다[6]. 답할 메모가 없으면 그것이 새 가지의 첫 장이 됩니다. 여기서 AI를 쓸 자리가 생깁니다. 지금 쓰려는 생각과 관련 있는 옛 메모를 찾아 달라고 하거나, 방금 쓴 메모에 반대되는 메모가 있는지 물어보는 일입니다. 루만의 색인이 하던 일을 맡기는 것이고, MIT 실험에서 중간에 있던 검색 엔진 쪽 역할입니다. 다만 메모의 문장은 직접 씁니다. 그 한 단계가 실험에서 기억과 소유감이 갈린 자리였습니다.
색인은 작게 둡니다. 루만은 핵심어 하나에 메모 번호를 한 개에서 네 개만 적었습니다[2]. 모든 메모에 태그를 다는 대신 주제마다 입구 메모를 하나만 정해 두고, 나머지는 메모 안의 링크를 따라가게 두는 편이 루만의 방식에 가깝습니다.
마지막으로, 기대의 크기를 맞춥니다. 루만은 상자가 쓸 만해지기까지 몇 년이 걸린다고 했습니다[5]. 한 달 뒤에 글이 술술 나오지 않는 것은 실패가 아니라 예정된 일입니다. 대신 한 달 뒤에 확인할 것은 따로 있습니다. 어느 메모 뒤에 다른 메모가 두세 장 붙어 있는지입니다. 그 자리가 다음 글의 첫 문단이 될 곳입니다.
필자 한마디
메모법 이야기는 늘 도구 이야기로 흘러갑니다. 어떤 앱을 쓸지, 태그를 어떻게 달지, 폴더를 몇 개로 나눌지. 루만의 상자를 세어 본 기록은 그 반대편을 가리킵니다. 그가 쓴 것은 엽서 크기 종이와 바뀌지 않는 번호, 그리고 몇 십 년이었습니다.
"메모상자는 저장 장치가 아니라 대화 상대였습니다. 대화 상대는 내가 한 말을 기억해야 나를 놀라게 할 수 있습니다." 그 말을 AI가 대신 하면 대화가 아니라 받아쓰기가 됩니다. 받아쓴 글은 몇 분 뒤에도 인용하기 어렵다는 것이 2025년의 작은 실험이 보여 준 것입니다.
오늘 읽은 것 가운데 한 문장만 제 말로 적어 두시고, 그 문장을 어느 옛 메모 뒤에 둘지만 정해 보세요. 그것이 루만이 매일 한 일의 전부였습니다.
정리하자면 이렇습니다. 루만의 메모상자는 빌레펠트 대학 아카이브의 집계로 약 9만 장이고, 두 상자에 나뉘어 있으며, 그 바탕 위에서 600편 가까운 글이 나왔습니다. 상자를 작동하게 한 것은 바뀌지 않는 번호, 5만 개의 참조, 입구만 알려 주는 작은 색인이었습니다. 임시·문헌·영구라는 세 종류 메모는 루만이 아니라 2017년 아렌스의 틀입니다. 메모상자는 글을 대신 써 주지 않았고, 몇 년이 지나서야 쓸 만해졌으며, 그때부터는 글의 시작점을 백지에서 이미 적어 둔 문장으로 옮겨 주었습니다. MIT 미디어랩의 2025년 실험은 작고 예비적인 결과이지만, 직접 쓴 문장과 AI가 쓴 문장이 머리에 남기는 흔적이 다르다는 쪽을 가리켰습니다.
그러니 메모를 쌓아 두면 글쓰기가 쉬워지느냐는 물음에는 이렇게 답하겠습니다. 쌓아 두기만 해서는 아닙니다. 제 손으로 쓰고, 서로 이어 두고, 몇 년을 기다리면 그렇습니다.
이 글은 일반적인 정보 제공을 위한 것입니다. 루만의 글과 아렌스의 책에서 가져온 문장은 필자가 옮긴 것이고, MIT 미디어랩의 연구는 동료 심사를 거치지 않은 공개본이므로 후속 연구에 따라 결론이 달라질 수 있습니다. 인용하실 때는 원문을 함께 확인하세요.
참고문헌
- Universität Bielefeld, Fakultät für Soziologie. Niklas Luhmann-Archiv(소개 페이지: 메모 약 9만 장, 1951~1996년, 출판물 약 600편·단행본 40권 이상, 2011년 유고 인수). 링크 ↩
- Schmidt, J. F. Niklas Luhmann's Card Index: The Fabrication of Serendipity. Sociologica 12(1), 53–60, 2018. 링크 ↩
- Schmidt, J., Gödel, M., Zimmer, S. Die Digitalisierung des Zettelkastens Niklas Luhmanns(빌레펠트 대학 발표 자료, 2018-04-19: 상자 I·II의 장수와 구획, 참조 약 2만·3만 개, 색인 항목 약 1,250·3,200개, 번호 체계 예시, 1987년 인터뷰 인용). PDF ↩
- Cologne Center for eHumanities. Niklas Luhmann – Theorie als Passion(디지털화 사업 소개, 2015~2030). 링크 ↩
- Luhmann, N. Kommunikation mit Zettelkästen. Ein Erfahrungsbericht, 1981(Kieserling 엮음 Universität als Milieu, 1992 재수록). 영역본 "Communications with Zettelkastens", zettelkasten.de. 링크 ↩
- Ahrens, S. How to Take Smart Notes, 2nd ed. 부록 "A glimpse into Luhmann's Zettelkasten"(9/8 구역 메모 17장, 메모 9/8b 번역, 기존 메모에 답으로 쓰라는 조언). 저자 공개 PDF. PDF ↩
- Schiller, M. Book review: Ahrens, S. (2017). How to Take Smart Notes. Journal of Writing Research 9(2), 227–231, 2017(출판사 CreateSpace; 루만의 두 상자 작업 방식 요약). 링크 ↩
- 숀케 아렌스, 김수진 옮김. 『제텔카스텐: 글 쓰는 인간을 위한 두 번째 뇌』. 인간희극, 2021-05-20. 링크 ↩
- zettelkasten.de. Concepts: Sönke Ahrens Explained(아렌스 책의 쪽수를 붙여 임시·문헌·영구 메모 정의를 인용한 글). 링크 ↩
- Kosmyna, N., Hauptmann, E., Yuan, Y. T., Situ, J., Liao, X.-H., Beresnitzky, A. V., Braunstein, I., Maes, P. Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task. arXiv:2506.08872, 2025-06-10(v2 2025-12-31). 링크 ↩
- MIT Media Lab. Your Brain on ChatGPT(프로젝트 소개와 한계 목록) 링크 · 연구진 공식 페이지 링크 ↩
- brainonllm.com. FAQ(언론에 '멍청해진다'·'뇌가 썩는다' 같은 표현을 쓰지 말아 달라는 연구진의 요청, 동료 심사 진행 중). 링크 ↩
- Chow, A. R. ChatGPT May Be Eroding Critical Thinking Skills, According to a New MIT Study. TIME, 2025-06-23(참가자 보스턴 지역 18~39세, 뇌 32개 영역, 공개 시점에 대한 코스미나의 말). 링크 ↩